Un budget n'est pas un frein : selon le réglage, il prévient, il coupe, ou il ne fait rien de plus qu'un rapport. Fin octobre 2026, Google Cloud a rendu ses plafonds de dépense disponibles pour tous, Anthropic a ouvert une API qui ventile le coût par clé et par utilisateur, GitHub a fait passer Copilot à un usage décompté dès la première requête, et Salesforce a mis en service un coupe-circuit pour ses agents. Quatre annonces sur un même sujet : mesurer et arrêter une dépense d'IA avant la facture. De quoi est fait le coût d'un modèle a déjà été traité. Cet article porte sur l'étape suivante : ce que fait vraiment chaque réglage quand le seuil est atteint, ce qu'il laisse passer, et comment votre code s'en aperçoit.
La question est devenue pressante avec les agents. Un assistant de discussion dépense à la vitesse de la frappe d'un humain. Un agent qui boucle, relance un outil ou réessaie après une erreur dépense à la vitesse d'une machine. Salesforce le dit en ces termes dans son annonce du 27 octobre : les agents peuvent échouer en silence, « en accumulant des coûts avant que quiconque s'en aperçoive ». Entre le moment où la dépense a lieu et celui où quelqu'un peut la voir, il y a un délai. Tout le sujet tient dans ce délai.
Trois réglages qu'on appelle « budget »
Dans une console de facturation, le mot « budget » recouvre des objets qui n'ont pas le même effet. La documentation des fournisseurs les sépare nettement. Les équipes, elles, les confondent souvent, et découvrent la différence le jour où la facture arrive.
OpenAI résume la différence en deux lignes dans sa page sur les limites de dépense. Au seuil, une alerte « envoie une notification ; le trafic d'API continue ». Un plafond dur fait échouer les requêtes concernées. La page ajoute une phrase qui devrait figurer dans toute procédure interne : « les alertes de dépense n'imposent pas de plafond ».
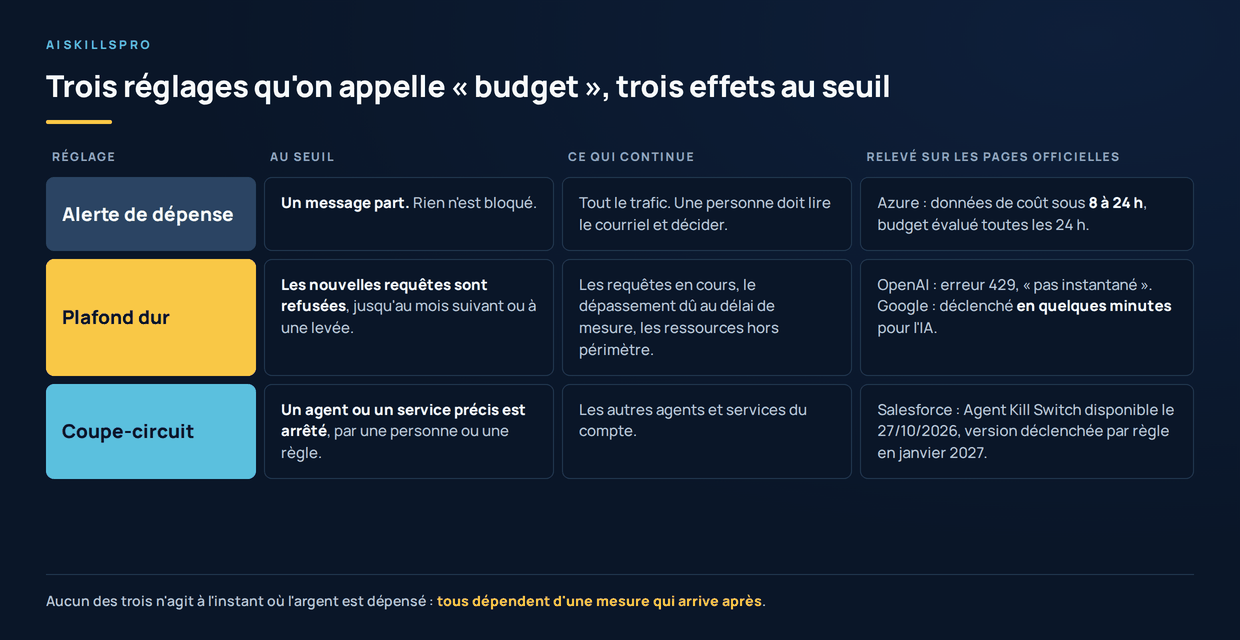
La figure compare les trois réglages ligne par ligne. La colonne du milieu est celle qui compte : ce qui se passe au seuil. Seuls les deux derniers réglages arrêtent quelque chose, et aucun des trois n'agit à l'instant même où l'argent est dépensé.
L'alerte : une information, pas un frein
Le budget le plus répandu est un budget d'alerte. Il compare la dépense à un montant prévu et envoie des courriels à certains seuils. Il ne bloque rien. Microsoft l'écrit sans ambiguïté dans sa documentation des budgets Azure : quand un seuil est franchi, « les ressources ne sont pas affectées et votre consommation n'est pas arrêtée ».
La même page donne le second chiffre à connaître. Les données de coût et d'usage sont « en général disponibles sous 8 à 24 heures », et les budgets sont évalués sur ces données « toutes les 24 heures ». Un agent qui s'emballe un soir peut donc tourner une nuit entière avant que le premier courriel parte. Chez Google Cloud, la page des budgets fait la même mise en garde : le premier courriel peut mettre « plusieurs heures » à arriver après la création du budget, et le budget d'alerte « ne fixe pas automatiquement de plafond ». Google recommande de régler le montant sous les fonds réellement disponibles, « pour tenir compte des délais de remontée de l'usage ».
L'alerte reste utile. Elle prévient avant qu'un plafond coupe le service, et elle signale une tendance. Mais elle suppose qu'une personne lise le courriel à temps et sache quoi arrêter. Pour une charge pilotée par des machines, ce n'est pas une protection, c'est un compte rendu.
Le plafond dur, et le dépassement qu'il laisse passer
Le plafond dur arrête le trafic. Il ne l'arrête pas pile au seuil. Pour décider de bloquer, le fournisseur doit d'abord savoir combien vous avez dépensé, et cette mesure prend du temps. OpenAI et Google l'écrivent noir sur blanc.
OpenAI écrit que l'application de la limite « n'est pas instantanée » : la plateforme peut traiter « une petite quantité d'usage supplémentaire » pendant que l'état de la limite se propage, et la dépense enregistrée peut donc dépasser légèrement le montant fixé. Google a fait de ce délai l'argument principal de ses plafonds de dépense, devenus disponibles pour tous fin octobre. Pour les services d'IA, ils se déclenchent « dans les minutes » qui suivent l'usage. Ils utilisent pour cela des coûts estimés en direct, au lieu d'attendre des heures que la chaîne de facturation consolide les coûts nets.
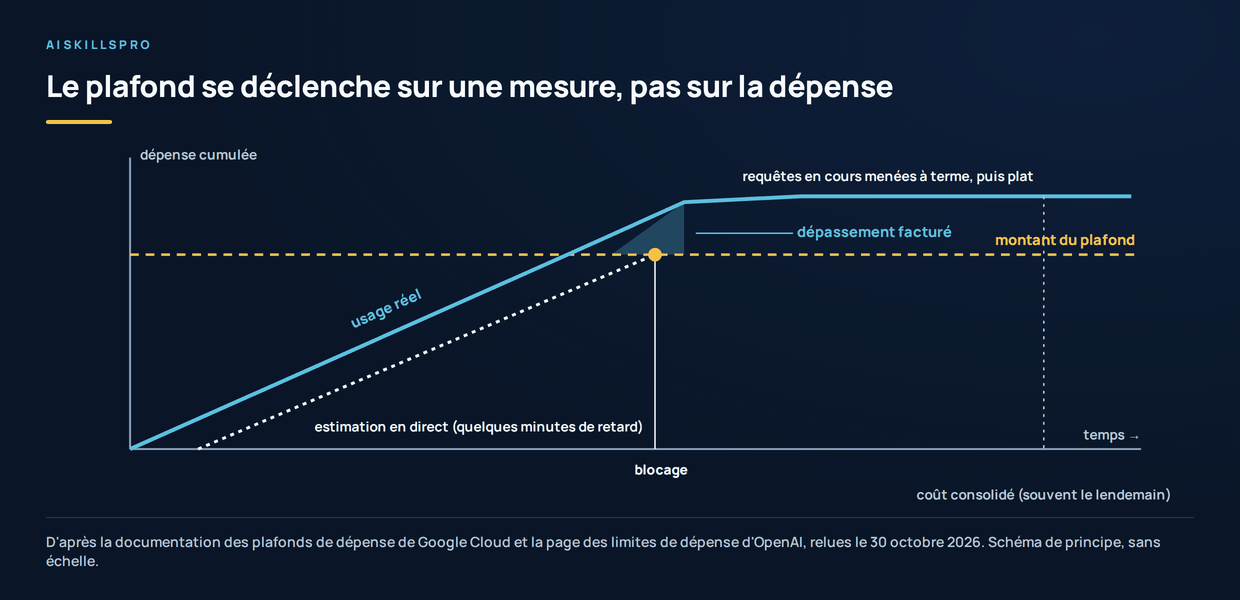
La figure suit une dépense dans le temps. L'usage a lieu, une estimation le rattrape quelques minutes plus tard, le plafond se déclenche sur cette estimation, puis le coût réel est consolidé, souvent le lendemain. Le dépassement, c'est l'écart entre l'usage réel et le plafond au moment du blocage, plus les requêtes encore en cours. La documentation des plafonds de Google en tire deux conséquences. Les requêtes déjà en cours au moment du blocage vont jusqu'au bout et sont facturées. Et tout dépassement dû au délai de mesure « est facturé normalement » : il reste à votre charge.
Un plafond dur a aussi une durée. Chez Google, un plafond déclenché bloque le service jusqu'à la fin de la période, sauf levée manuelle. Depuis la disponibilité générale, il se remet à zéro automatiquement au début du mois suivant ; une option garde la levée manuelle pour ceux qui veulent un contrôle avant reprise. Après une levée, le service peut mettre jusqu'à une heure pour reprendre normalement. Chez Anthropic, le plafond mensuel de chaque palier suspend l'API jusqu'à minuit UTC le premier jour du mois suivant, comme l'explique la page des limites. Ces plafonds valent 500 dollars au palier Start, 1 000 au palier Build et 200 000 au palier Scale. Vous pouvez fixer votre propre limite en dessous.
Ce que le plafond coupe, et ce qu'il épargne
Un plafond ne coupe jamais « tout ». Il coupe un périmètre, et ce périmètre varie beaucoup d'un fournisseur à l'autre. C'est la deuxième chose à lire avant d'activer quoi que ce soit.
Chez Google, un plafond porte sur un seul projet et un seul service à la fois. Les services éligibles, au 30 octobre, sont l'API Gemini, Agent Platform (ex-Vertex AI), Cloud Run et Cloud Run functions. Les ressources persistantes, comme le calcul et le stockage, continuent de tourner et de facturer. Le débit réservé (Provisioned Throughput) n'est « jamais interrompu », précise l'annonce de disponibilité générale. Chez OpenAI, deux plafonds peuvent s'appliquer à la même requête : celui de l'organisation, qui couvre tous les projets, et celui du projet. Un troisième existe sans que vous l'ayez réglé : la limite d'usage mensuelle qu'OpenAI attribue à chaque organisation selon son palier.
GitHub a fait un choix différent pour Copilot. Sa note du 28 octobre annonce que l'usage d'IA des entreprises concernées est décompté « dès la première requête » sur le budget de l'entreprise, sans forfait inclus par siège. Quand ce budget est épuisé, tout ne s'arrête pas. La complétion de code et les suggestions de modification continuent. Copilot Chat, la revue de code et Copilot dans le cloud demandent du budget disponible. GitHub résume : un budget épuisé « ne retire jamais l'accès ». C'est un plafond qui dégrade le service au lieu de le couper, et c'est un choix de conception, pas une faiblesse.
AWS, enfin, agit surtout par les permissions. Une action de budget peut appliquer une politique de droits qui interdit de créer de nouvelles ressources, automatiquement ou après approbation manuelle, par exemple à 90 % du coût prévu pour le mois. Elle peut aussi viser des instances EC2 ou RDS précises. L'effet est réel, mais il faut le construire soi-même et décider de ce que la politique interdit.
Une coupure qui ressemble à une limite de débit
Le jour où un plafond se déclenche, votre code reçoit une erreur. La manière dont il la traite décide de ce qui se passe ensuite. Or cette erreur ressemble souvent à une autre, beaucoup plus banale.
Chez OpenAI, un plafond dur atteint renvoie une erreur HTTP 429, le code des limites de débit, avec un code précis : organization_spend_limit_exceeded ou project_spend_limit_exceeded. Chez Anthropic, le plafond du palier renvoie aussi une 429, de type rate_limit_error, « le même que pour une limite de débit ». La différence tient dans deux détails : la réponse ne porte pas d'en-tête retry-after, et le champ error.details.error_code vaut enforced_spend_limit_reached. La documentation prévient que réessayer, « y compris les nouvelles tentatives automatiques du kit de développement », échoue tant que l'accès n'est pas rétabli. Quand c'est votre propre limite qui est atteinte, Anthropic répond par une erreur 400 et un message qui le dit en clair. Seule exception relevée : l'espace de travail réservé à son outil de code renvoie une 429 accompagnée d'un retry-after.
Le même raisonnement vaut pour la reprise. Chez OpenAI, relever la limite rétablit le trafic « une fois la mise à jour propagée ». Chez Google, le service peut mettre une heure à revenir. Une procédure d'astreinte qui suppose un retour immédiat se trompera.
Attribuer avant de plafonner
Un plafond global protège la trésorerie. Il ne dit pas qui a dépensé, et il coupe tout le monde en même temps : l'agent qui boucle comme l'application qui sert vos clients. Pour plafonner finement, il faut d'abord savoir mesurer finement. C'est l'objet de l'attribution.
Anthropic a lancé le 29 octobre une API d'analytique de l'usage et des coûts, en version bêta, annoncée dans ses notes de version. Elle permet de filtrer et de regrouper la consommation par modèle, par espace de travail, par clé d'API, et par utilisateur ou compte de service à l'origine de chaque requête. L'ancienne API d'usage et de coût passe au statut d'API héritée, toujours prise en charge. GitHub, de son côté, s'appuie sur les politiques, les alertes et l'attribution déjà en place dans l'entreprise. Salesforce a mis en disponibilité générale, le 27 octobre, un tableau de bord financier, un « Model Wallet », présentés comme une vue unique des dépenses d'IA assortie de plafonds durs, et des politiques d'optimisation des coûts, ainsi que son coupe-circuit d'agent. La version déclenchée automatiquement par les évaluations est annoncée pour janvier 2027.
La règle qui s'en dégage est simple. Une clé ou un projet par usage, et un plafond par clé ou par projet, dimensionné pour cet usage. Le bac à sable d'un développeur n'a pas besoin du même plafond que la production. Google conseille d'ailleurs de commencer par des plafonds bas sur les environnements hors production et les terrains d'essai d'agents. Les techniques pour répartir le trafic entre modèles et poser des quotas en amont, au niveau d'une passerelle, sont détaillées dans Router ses appels IA entre plusieurs modèles.
Ce que cela change dans la pratique
Aucun réglage ne suffit seul. L'alerte prévient, le plafond borne, le coupe-circuit isole, l'attribution explique. Ils se complètent, à condition de savoir ce que chacun fait réellement chez votre fournisseur.
Le plafond ne remplace pas la limite qu'on fixe à l'agent lui-même : nombre d'étapes, durée maximale, nombre d'appels d'outil. Un agent qui tourne longtemps sans contrôle finit par coûter cher, et cela ne tient pas qu'au prix des jetons. La durée pendant laquelle un agent tient seul est étudiée dans Combien de temps un agent tient-il tout seul, et la question de qui répond de ses actes, coupure comprise, dans Gouverner un agent autonome.
Une dépense d'IA se pilote comme un débit, pas comme un stock. Ce qui vous protège, c'est la vitesse à laquelle la mesure rattrape l'usage, et le réflexe de votre code quand le seuil est atteint. Pour estimer ce qu'un agent coûte avant même de régler ces garde-fous, voyez Combien coûte vraiment un agent IA. Les évolutions de prix et de facturation sont suivies chaque semaine dans le radar IA.
Une question, un projet IA ?
Vous voulez savoir ce que vos budgets d'IA arrêtent vraiment, et ce qu'un agent en boucle pourrait coûter avant la première alerte ? Échangeons sur votre contexte.
Prendre contact →