Le nom d'un modèle n'est pas une version. Ce 23 octobre 2026, OpenAI a coupé l'accès à une série de modèles dont le retrait avait été annoncé en avril, parmi lesquels gpt-4-turbo, o1 et gpt-3.5-turbo. Dans la même semaine, DeepSeek a changé le modèle servi sous le nom deepseek-flash, GitHub a retiré six modèles de Copilot, et Notion a confié le choix du modèle à un routeur. Le bulletin de la semaine a relevé ces faits. Cet article en tire le mécanisme : ce qui peut changer derrière un nom, qui le décide, avec quel préavis, et comment s'en protéger.
Le sujet paraît administratif. Il ne l'est pas. Un test fait le mois dernier, une évaluation de conformité ou une chaîne de traitement réglée au millimètre portent sur un modèle précis. Si ce modèle a changé sans que le nom change, la validation ne vaut plus, et personne ne s'en aperçoit avant le premier écart.
Cinq couches derrière « le modèle »
Dans une conversation, « le modèle » désigne une marque : un nom de gamme dans un menu déroulant. Dans le code, c'est une chaîne de caractères passée à une interface de programmation. Entre les deux, il y a plusieurs objets distincts, que la documentation des fournisseurs sépare nettement et que les équipes confondent souvent.
À ces trois objets s'en ajoutent deux autres. Au-dessus, l'outil qui vous sert le modèle (un assistant de code, un espace de travail, un chatbot d'entreprise) peut choisir ou remplacer le modèle à votre place. En dessous, l'infrastructure de service, qui entoure les poids, peut évoluer. Cela fait cinq couches, et chacune a son propre rythme de changement.
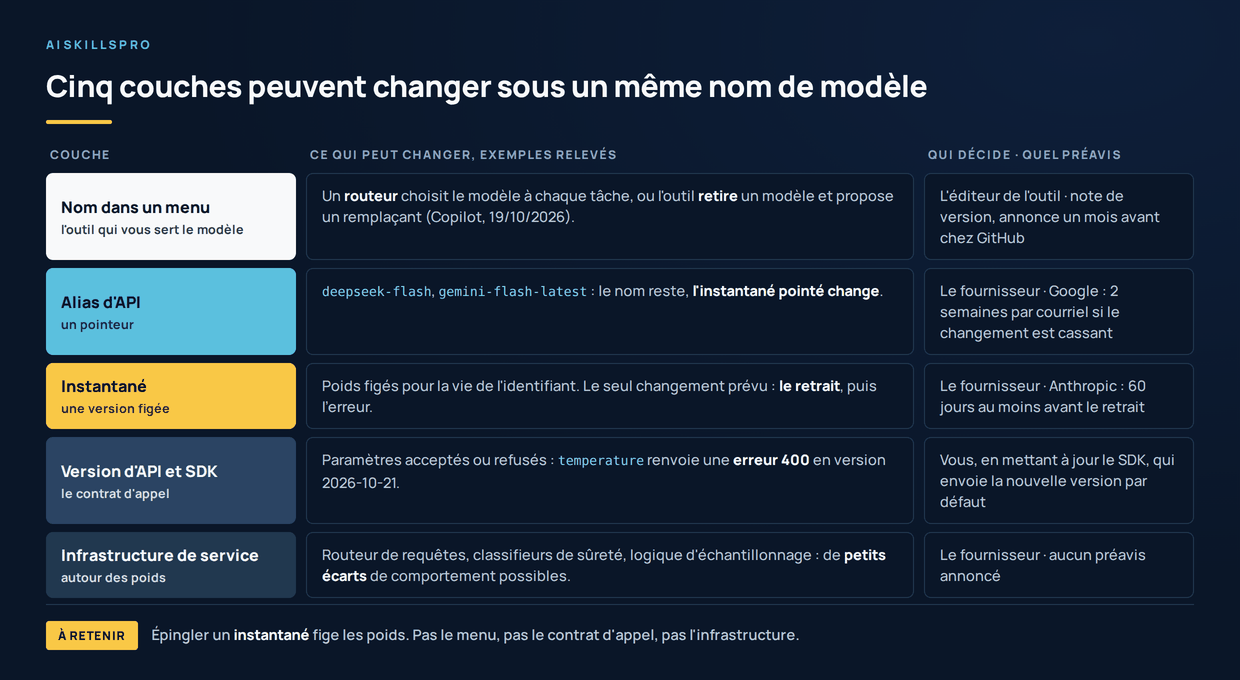
La figure se lit de haut en bas, de la couche la plus visible à la plus discrète. La colonne de droite est la plus importante : elle dit qui peut changer la couche, et si vous en serez prévenu. Plus on descend, plus le changement est rare, mais moins il est annoncé.
L'alias : un pointeur qui se déplace
L'alias existe pour une bonne raison : vous éviter de modifier votre code à chaque amélioration. Google le dit sans détour dans sa convention de nommage des modèles Gemini. Un nom en -latest, comme gemini-flash-latest, « pointe vers la dernière version » d'une variante. Cette version peut être stable, en aperçu ou expérimentale, et l'alias est « échangé à chaud à chaque nouvelle version ». Google promet un préavis de deux semaines par courriel, mais seulement pour les changements qu'il juge cassants. La même page recommande, pour la plupart des applications en production, un modèle stable à l'identifiant précis.
DeepSeek a fait jouer ce mécanisme le 17 octobre. Sa note de version annonce que le modèle Flash « a été mis à jour » vers DeepSeek-V4.1-Flash-1017. Elle précise que « la méthode d'appel et le prix restent inchangés » : il suffit d'appeler deepseek-flash pour obtenir le dernier modèle. Le site et l'application ont basculé le même jour. L'éditeur publie des scores en hausse sur une dizaine de bancs d'essai, et il est seul à les avoir mesurés. Pour une équipe qui appelle ce nom, le modèle a changé le 17 octobre sans qu'une ligne de son code bouge.
Anthropic a longtemps proposé le même confort. Sa page sur les identifiants de modèles explique que, pour les modèles antérieurs à la génération 4.6, des alias courts comme claude-sonnet-4-5 pointent vers « l'instantané daté le plus récent » de la version. Depuis la génération 4.6, l'éditeur a changé de règle : un identifiant sans date, comme claude-sonnet-4-6, n'est pas un alias. La page réfute expressément l'idée qu'il renverrait toujours vers la meilleure version : il désigne un instantané unique, et une version améliorée sort sous un nouvel identifiant.
L'instantané : figé, puis retiré
Épingler un instantané résout le premier problème. Les poids ne bougent plus, et votre validation porte sur un objet stable. En échange, vous héritez d'un second problème : cet objet a une date de fin. Les fournisseurs décrivent ce cycle avec un vocabulaire proche. Celui d'Anthropic est le plus explicite. Sa page des dépréciations distingue quatre états : actif, ancien (plus de mises à jour), déprécié (le modèle fonctionne, une date de retrait et un remplaçant sont fixés) et retiré (« les requêtes échouent »).
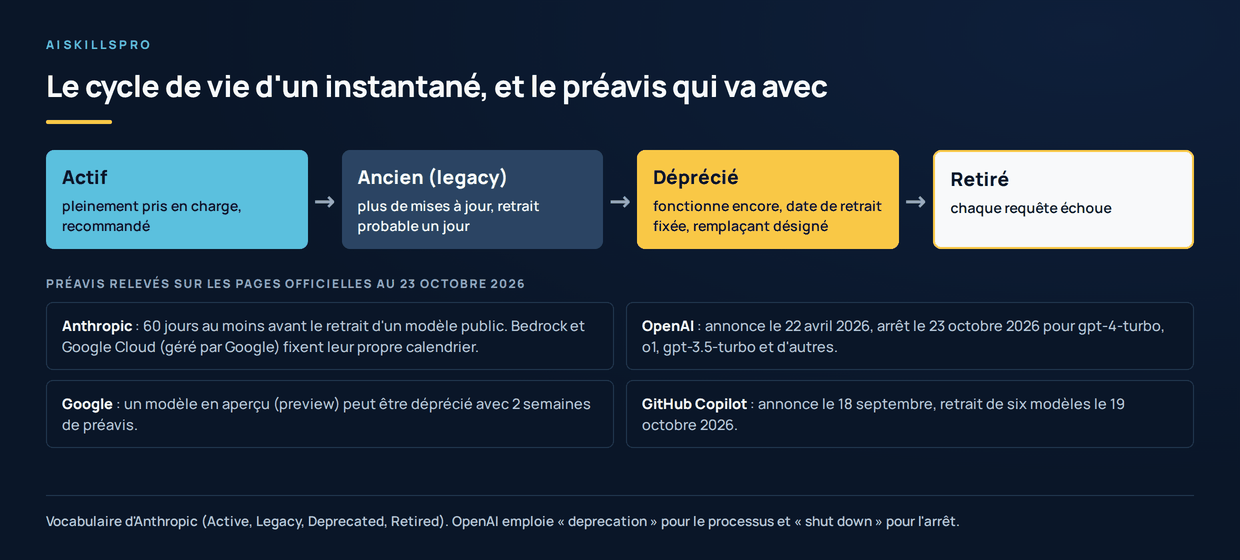
Le préavis varie fortement selon le fournisseur et le statut du modèle. Anthropic s'engage sur au moins 60 jours avant le retrait d'un modèle publié. OpenAI a annoncé le 22 avril 2026 les arrêts qui prennent effet aujourd'hui, soit six mois plus tôt. Le 14 octobre, il a annoncé le retrait de GPT-4o et de GPT-4.1 pour le 14 janvier 2027, soit trois mois de préavis. Chez Google, un modèle en aperçu peut être déprécié avec au moins deux semaines de préavis. C'est la principale raison de ne pas bâtir une production sur un modèle en aperçu, même facturé.
Une petite ligne compte davantage qu'elle n'en a l'air. Anthropic précise que ses dates valent pour les plateformes qu'il opère lui-même. Amazon Bedrock et Google Cloud, quand le service est géré par Google, « fixent leur propre calendrier de retrait ». Le même modèle peut donc être retiré à deux dates différentes selon le guichet par lequel vous l'appelez. Si vous passez par un hébergeur, c'est sa page qui fait foi, pas celle de l'éditeur du modèle.
Le retrait touche aussi les outils. Le 19 octobre, GitHub a retiré six modèles de la plupart des usages de Copilot, comme annoncé le 18 septembre, chacun avec un remplaçant suggéré. La note ajoute que les administrateurs de Copilot Enterprise « peuvent avoir besoin » d'autoriser eux-mêmes les remplaçants dans leurs politiques de modèles. Le retrait est donc automatique, mais l'accès au remplaçant ne l'est pas toujours.
Même identifiant, comportement différent
Un instantané épinglé fige les poids. Il ne fige pas tout. Anthropic l'écrit dans la page déjà citée : les poids sont fixes pour un identifiant donné, mais « l'infrastructure de service autour du modèle peut changer ». Il cite le routeur de requêtes, les classifieurs de sûreté et la logique d'échantillonnage. Ces mises à jour produisent « parfois de petites différences de comportement observable », à identifiant et à poids inchangés. L'éditeur ajoute que c'est la cause la plus probable d'un écart inattendu sur un identifiant jusque-là stable.
Cette variabilité s'ajoute à celle, déjà connue, d'un même modèle interrogé deux fois. Ses causes techniques sont détaillées dans Pourquoi la même question ne donne pas la même réponse. La différence est de nature : la variabilité d'un appel à l'autre se mesure en répétant la question, alors qu'une dérive se mesure en comparant deux périodes.
La dérive n'est pas une hypothèse d'école. Une étude publiée en 2023 a comparé les versions de mars et de juin 2023 de GPT-4 et GPT-3.5 sur les mêmes tâches. Pour reconnaître un nombre premier, GPT-4 est passé de 84 % à 51 % de bonnes réponses. Les auteurs concluent que le comportement du « même » service peut changer substantiellement en peu de temps, et recommandent une surveillance continue. Les modèles ont changé depuis, et ces chiffres ne disent rien des modèles actuels. Le phénomène, lui, est documenté.
Reste la couche du contrat d'appel. Le 21 octobre, Anthropic a publié la version d'API 2026-10-21. Les paramètres temperature, top_p et top_k y sont supprimés : une requête qui en envoie un « renvoie une erreur 400 sur tous les modèles ». La version est choisie par un en-tête de requête, et la page rappelle que les kits de développement s'en chargent pour vous. Or, selon les notes de version du même jour, les nouveaux kits (Python 2.0.0, TypeScript 1.0.0 et les autres) envoient cette version par défaut. Une simple mise à jour de dépendance change donc le contrat, sans toucher au modèle. Le rôle de ces curseurs est expliqué dans Temperature, top-p : les curseurs qui rendent une IA créative ou déterministe.
Le routeur : le modèle choisi à votre place
La dernière couche est la plus récente dans les outils grand public et professionnels : le routeur. Plutôt que de vous faire choisir un modèle, l'outil choisit pour chaque tâche. Le 19 octobre, Notion a présenté la nouvelle version de son routeur, « Auto », dans sa page des nouveautés : elle « associe chaque tâche au bon modèle, en équilibrant qualité, vitesse et coût », et « change de cap » si elle bloque. Notion affirme que, sur plus de vingt tâches courantes, Auto donne des résultats proches des modèles de pointe pour un coût moyen inférieur d'environ 90 %. Le protocole de cette mesure n'est pas détaillé dans l'annonce.
L'économie peut être réelle. Le prix à payer est ailleurs : avec un routeur, la question « quel modèle a produit cette réponse ? » n'a plus de réponse unique. Elle dépend de la tâche et du moment. Pour un brouillon, c'est sans importance. Pour une réponse qui engage l'entreprise, un traitement de données sensibles ou un résultat qu'il faudra expliquer plus tard, c'est une perte de traçabilité. Notion annonce pour bientôt un centre de commande qui montrera l'usage par personne, par fonction et par agent, et permettra de décider quels modèles l'équipe peut utiliser. L'annonce ne promet pas de dire, réponse par réponse, quel modèle a répondu.
Les mêmes arbitrages se posent quand c'est vous qui routez vos propres appels entre plusieurs fournisseurs. Les passerelles, les règles de repli et leur coût sont traités côté pratique dans le volet Outils (voir « Aller plus loin » en fin de page).
Ce que cela change dans la pratique
Aucune de ces couches n'est un défaut en soi. L'alias évite des migrations inutiles, le retrait libère de la capacité pour les modèles suivants, le routeur fait baisser la facture. Le problème vient de l'écart entre ce que vous croyez avoir validé et ce qui répond réellement. Réduire cet écart demande peu de moyens, mais de la constance.
Ce travail a un prolongement stratégique. Un modèle peut être retiré, un hébergeur peut retirer un modèle avant son éditeur, un outil peut changer de fournisseur sous le même menu. Plus votre application dépend d'un seul identifiant, plus chacun de ces événements vous coûte. Les moyens de garder une porte de sortie (couche d'abstraction, tests de portabilité, plan de repli) sont présentés dans Ne pas dépendre d'un seul fournisseur d'IA.
Un nom de modèle désigne une famille, rarement un objet fixe. Ce qui vous engage, c'est l'identifiant précis qui a répondu, à une date donnée, à travers un contrat d'appel donné. Les retraits et les changements de version sont suivis chaque semaine dans le radar IA.
Une question, un projet IA ?
Vous voulez savoir quels modèles vos applications appellent vraiment, et ce qu'un retrait annoncé va casser ? Échangeons sur votre contexte.
Prendre contact →