Deux équipes branchent le même modèle sur le même dépôt de code. L'une obtient un agent qui livre, l'autre un agent qui tourne en rond. La différence n'est pas dans le modèle : elle est dans tout ce qui l'entoure. En 2026, ce « tout ce qui l'entoure » a reçu un nom, harness engineering, l'ingénierie du harnais, et il s'est imposé dans les publications d'ingénierie de l'année.
Le mot est neuf, la pratique l'est moins. Ce qui change, c'est qu'on commence à la mesurer. Et les premières mesures disent des choses inconfortables : une bonne part de ce qu'on écrit pour guider un agent ne contrôle rien du tout.
D'où vient le mot, et ce qu'il désigne
Le 5 février 2026, un développeur connu pour avoir cofondé un éditeur d'outils d'infrastructure publie le récit de son adoption des agents de code. Une étape y porte le nom « engineer the harness », et sa définition tient en une phrase : chaque fois qu'un agent commet une erreur, prendre le temps de construire une solution pour qu'il ne la commette plus jamais. Il précise que, dans le fichier de consignes de l'un de ses projets, chaque ligne correspond à un mauvais comportement observé.
Six jours plus tard, OpenAI publie un retour d'expérience intitulé « Harness engineering ». Selon le compte rendu qu'en donne InfoQ, une petite équipe y a construit et livré en cinq mois un produit d'environ un million de lignes « sans aucun code source écrit à la main ». Le rôle des ingénieurs s'est déplacé : ils conçoivent l'environnement, précisent l'intention et organisent le retour d'information. L'architecture n'y est pas confiée à la bonne volonté de l'agent : l'ordre des couches de dépendances est imposé par des règles mécaniques et des tests structurels, et la documentation elle-même est vérifiée par des linters et par l'intégration continue.
Le 2 avril, une consultante de Thoughtworks donne au sujet sa forme la plus citée : Agent = Modèle + Harnais.
La définition générale de la discipline, ses piliers et ce qui la sépare du machine learning classique sont posés dans AI engineering, c'est quoi vraiment ?. Le harnais en est la partie qui a le plus bougé depuis : c'est là que se jouent aujourd'hui la fiabilité et le coût d'un agent.
Guides et capteurs : les deux moitiés du harnais
L'apport le plus utile de l'article de Thoughtworks est une grille, empruntée à la théorie du contrôle. Elle range tout ce qui entoure le modèle selon deux axes.
Le premier axe sépare le moment de l'action. Les guides agissent avant : ils orientent l'agent pour augmenter la probabilité d'un bon résultat du premier coup. Les capteurs agissent après : ils observent ce que l'agent a produit et lui renvoient de quoi se corriger, d'autant plus efficaces que leur signal est lisible par un modèle.
Le second axe sépare la nature du contrôle. Un contrôle calculatoire est déterministe et rapide : un test, un linter, un vérificateur de types, une analyse de structure. Un contrôle inférentiel passe par un modèle : une revue de code par IA, un « modèle juge ». Il voit plus de choses, mais il est plus lent, plus cher, et son verdict n'est pas reproductible à l'identique.
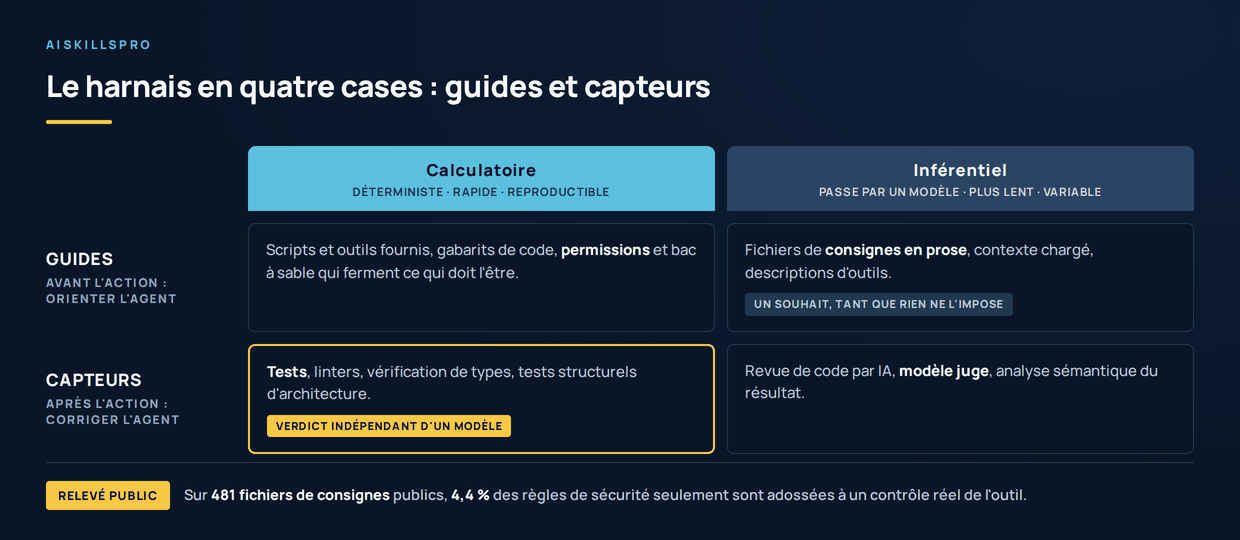
La grille sert d'abord à faire l'inventaire. Faites l'exercice sur votre propre installation : si la case des guides inférentiels — des consignes en prose — déborde et que celle des capteurs calculatoires est presque vide, le harnais repose sur la bonne volonté du modèle. Or les capteurs calculatoires sont les seuls dont le verdict ne dépend pas d'un modèle. L'auteure le dit sans détour : on est encore loin d'avoir des harnais du comportement fonctionnel assez solides pour réduire la supervision et les tests manuels.
Une règle écrite n'est pas un contrôle
Une étude mise en ligne le 24 août 2026 a passé au crible 481 fichiers de consignes publics rédigés pour un agent de terminal très répandu. Elle en a extrait les règles de sécurité — « ne jamais lire tel fichier », « ne pas pousser sur telle branche » — puis a vérifié, avec deux praticiens de la sécurité, lesquelles étaient adossées à un contrôle réel de l'outil : une permission, un mode, un bac à sable.
Le résultat, selon la mesure la plus stricte : 4,4 % (intervalle de confiance à 95 % : 2,6 à 6,7 %). Les autres règles dépendent entièrement de la façon dont le modèle interprète la phrase. L'auteur y voit un problème d'ergonomie de la sécurité plus qu'une faute des développeurs : rien ne leur signale qu'une règle écrite ne sera appliquée par aucun mécanisme. La phrase « ne fais pas ça » et l'interdiction technique de le faire se ressemblent dans un fichier texte. Elles n'ont pas la même valeur.
Stripe arrive au même constat par un autre chemin. Dans une douzaine d'expériences publiées en mai sous un titre explicite, « You can't whisper at an AI agent », ses équipes ont tenté d'orienter des agents par des signaux discrets : des notes dans les fichiers de dépendances, des avertissements dans les réponses d'une interface de programmation. Les agents les ont ignorés. Ce qui a fonctionné, ce sont les signaux durs : une erreur explicite qui bloque, un contexte chargé au bon moment. Un agent pressé de finir sa tâche ne lit pas les marges.
Reste l'idée de laisser l'utilisateur écrire lui-même sa politique. Une seconde étude du même auteur, conduite auprès de 113 participants, l'a comparée à l'approbation action par action. Les politiques rédigées par les participants ont bloqué 20,1 points de moins de dépassements. La raison est instructive : sur 140 règles écrites, 114 disaient « demander ». La décision était repoussée au moment de l'action, où 133 des 148 dépassements ont finalement été approuvés.
Plus de contexte ne fait pas un meilleur harnais
Le réflexe naturel, quand un agent se trompe, est de lui en dire plus. Une équipe de l'ETH Zurich a mesuré l'effet des fichiers de contexte placés à la racine des dépôts, ceux qui décrivent le projet à l'agent. Sa conclusion, révisée fin septembre 2026 : fournir ces fichiers n'améliore pas, en général, le taux de réussite des tâches, et augmente le coût d'inférence de plus de 20 % en moyenne.
Le détail mérite d'être lu avec soin, parce qu'il circule souvent simplifié. Les fichiers générés automatiquement font baisser la réussite dans 5 configurations sur 8, d'un demi-point à deux points selon le banc d'essai — mais ces écarts ne sont pas statistiquement significatifs. Les fichiers écrits par les développeurs font mieux, environ 2,4 points de gain moyen, sans être significatifs non plus. La recommandation des auteurs est sobre : n'y mettre que ce que le code ne dit pas déjà, c'est-à-dire les pratiques non standard, et mesurer avant de généraliser. Les vues d'ensemble du dépôt, pourtant partout recommandées, n'ont pas aidé.
Le même principe vaut pour les outils. Vercel a remplacé quinze outils spécialisés de son agent d'analyse de données par une seule capacité : exécuter des commandes et lire des fichiers. Sur son banc d'essai, la réussite est passée de 4 requêtes sur 5 à 5 sur 5, le temps d'exécution de 274,8 à 77,4 secondes, la consommation d'environ 102 000 à 61 000 jetons. Cinq requêtes, c'est un signal, pas une preuve : le billet ne prétend pas davantage. La condition est écrite dans le billet, et c'est elle qu'il faut retenir : la couche de données que l'agent lisait était déjà bien documentée, avec des fichiers structurés et des noms clairs. Retirer des outils n'a marché que parce que l'environnement était lisible.
Le harnais tient la mémoire que le modèle n'a pas
Un agent qui travaille longtemps se heurte à une limite simple : chaque nouvelle session repart sans souvenir de la précédente. Anthropic a décrit en novembre 2025 le harnais qu'il a construit pour ce cas. Une première session prépare le terrain : un script de démarrage, un fichier de progression, un premier commit. Les suivantes avancent fonctionnalité par fonctionnalité et laissent le dépôt propre.
La pièce maîtresse est une liste de plus de 200 fonctionnalités vérifiables, toutes marquées « en échec » au départ. Elle répond à la panne la plus fréquente observée : l'agent qui déclare victoire trop tôt. Une liste structurée, que l'agent coche au lieu de la rédiger, transforme « j'ai fini » en affirmation vérifiable. Le reste de la continuité passe par l'historique git et les notes de progression, que chaque session relit en commençant.
Autrement dit, la mémoire d'un agent de longue durée n'est pas dans le modèle : elle est dans des fichiers que le harnais impose de tenir à jour. C'est la version outillée de ce qu'expliquent La mémoire des agents : pourquoi un agent « oublie » et Combien de temps un agent tient-il tout seul.
Ce que cela change dans la pratique
Le harnais déplace le travail de l'ingénieur. Ce dernier écrit moins de code et en conçoit davantage autour : les tests qui servent de capteurs, les règles mécaniques qui gardent l'architecture, les listes qui définissent « fini ». La boucle décrite en février est exigeante : chaque erreur de l'agent devient un correctif durable, et ce correctif vaut d'autant plus qu'il est calculatoire.
Le harnais est aussi du code, et il faut le traiter comme tel. Une synthèse publiée fin septembre par l'agence Marmelab, portant sur 246 dépôts et 57 publications, relève que parmi les 97 plus gros dépôts de harnais étudiés, 60 % n'ont ni test ni évaluation. Un harnais non mesuré n'est pas un harnais : c'est une collection d'intuitions. La mesure elle-même est traitée dans Évaluer une sortie d'IA : les evals, et sa version en production dans Mesurer la qualité d'un assistant IA en production.
Enfin, le harnais change ce que l'on compare. Mettre deux modèles en concurrence sans regarder leur harnais revient à comparer deux moteurs montés dans des voitures différentes. Le choix d'un modèle compte, mais à modèle égal, l'écart vient de ce qu'on a construit autour.
Un modèle se choisit sur catalogue ; un harnais se construit, erreur après erreur. C'est pour cela que deux équipes équipées du même modèle n'obtiennent pas le même agent. Les déplacements du secteur sont suivis semaine après semaine dans le radar IA.
Une question, un projet IA ?
Vos agents se trompent toujours aux mêmes endroits et vous cherchez quoi mesurer, quoi retirer, quoi verrouiller ? Échangeons sur votre contexte.
Prendre contact →