L'interface dit « conversation ». Elle se souvient de la veille, elle propose un bouton « supprimer » et un historique que l'on peut désactiver. Tout, dans sa forme, rappelle l'échange oral : on essaie, on se reprend, on pose la question naïve qu'on n'oserait pas poser à un collègue. Les outils d'administration voient la même chose tout autrement : un écrit daté, rattaché à un compte, rangé avec les courriels, que l'on peut retrouver, geler et exporter. Entre les deux lectures, c'est la seconde qui compte quand un litige s'ouvre.
La thèse de cet essai tient en une phrase : au travail, une conversation avec un assistant d'IA n'est pas une conversation, c'est un écrit de l'entreprise, conservé selon des règles que l'utilisateur ne voit pas, recherchable par d'autres que lui et produisible devant un juge. Il faut donc l'écrire comme on écrit un courriel professionnel, et l'organisation doit le gouverner comme elle gouverne sa messagerie. Ce n'est pas une alerte sur la surveillance. C'est un constat sur la nature d'un document que l'interface ne présente pas comme tel.
Ce que Google a rangé le 22 octobre
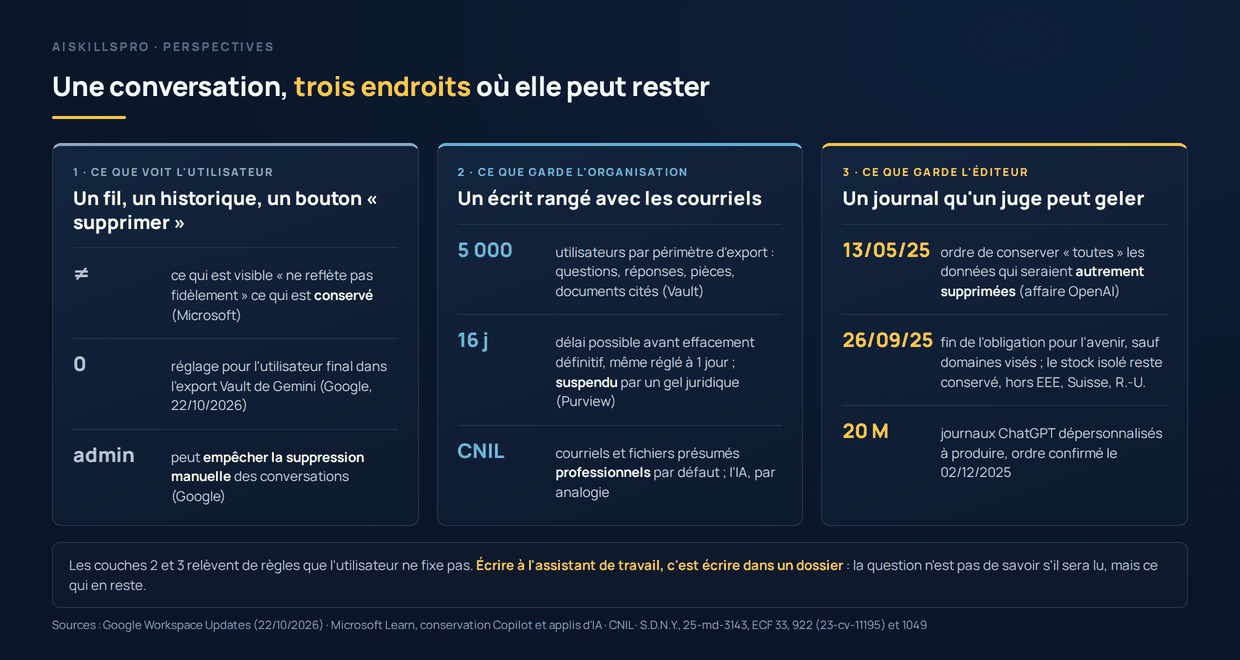
Le 22 octobre 2026, Google a annoncé que Google Vault exporte désormais les conversations avec Gemini dans Workspace. Vault est l'outil de conservation et d'eDiscovery de la suite : il sert, selon Google, à gouverner et exporter les données de Workspace « pour satisfaire aux obligations légales et réglementaires ». La nouveauté permet aux administrateurs de « filtrer et exporter les conversations des utilisateurs avec Gemini » dans Gmail, Drive, Docs, Sheets, Slides et Meet, par compte ou par unité d'organisation (un service, un site, un groupe de comptes défini dans la console), jusqu'à 5 000 utilisateurs par périmètre, et sur une plage de dates.
Le contenu de l'export est précis : les questions posées, les réponses de l'IA, les pièces générées, comme les images, et les liens vers les documents et fils de courriel auxquels l'assistant s'est référé. Le tout part au format JSON, depuis l'interface, puis par l'API dans les quatorze jours. Google précise que les règles de conservation et les gels juridiques pour ces conversations « suivront dans de prochaines versions ». Pour l'application Gemini elle-même, le centre d'aide de Vault propose déjà des rubriques pour conserver, geler et rechercher ses messages.
Deux lignes de l'annonce disent l'essentiel. La première : les réglages d'historique et de suppression se fixent par unité d'organisation, dans la console d'administration, et permettent d'empêcher la suppression manuelle des conversations par les utilisateurs ou de programmer leur effacement automatique après une période d'inactivité. La seconde, à propos de l'export : « There is no end-user setting for this feature », l'utilisateur final n'a aucun réglage. L'utilisateur voit un historique qu'il croit sien ; c'est l'organisation qui décide s'il peut le supprimer, et quand il disparaît.
Les articles de ce site sur le sujet regardaient jusqu'ici ce qui part chez l'éditeur : ce qu'on a le droit de mettre dans ChatGPT au regard du RGPD, ce qui quitte votre machine quand un assistant travaille sur votre code. Le fait du 22 octobre déplace la question vers l'intérieur : ce que l'entreprise garde de vos échanges, et ce qu'elle peut en faire.
Ce n'est pas une particularité de Google
Ce n'est pas une décision isolée : Google rejoint une architecture que Microsoft documente déjà. La page de Microsoft sur la conservation des échanges avec Copilot et les applications d'IA, mise à jour le 26 septembre 2025, décrit le mécanisme sans détour : les données des messages d'IA générative sont stockées « dans un dossier caché de la boîte aux lettres de l'utilisateur ». Ce dossier n'est pas fait pour être consulté directement, ni par l'utilisateur ni par l'administrateur : il sert à stocker des données « que les administrateurs de la conformité peuvent rechercher avec les outils d'eDiscovery ».
La liste des sources couvertes est le second indice. Les règles de conservation de Microsoft Purview visent Microsoft 365 Copilot, mais aussi ChatGPT Enterprise et, dans une catégorie « autres applications d'IA », ChatGPT, Google Gemini, la version grand public de Copilot et DeepSeek. Une autre page de la même documentation précise comment ces applications tierces sont repérées : par l'activité du navigateur. Les politiques de collecte permettent alors de « capturer et stocker toutes les invites et réponses détectées », y compris pour des applications non gérées classées comme IA générative. Nous en déduisons, sans que la documentation le formule ainsi, qu'un compte personnel ouvert dans un navigateur professionnel n'échappe pas forcément au dispositif.
Côté éditeurs de modèles, le mouvement est le même. Anthropic décrit une interface de conformité qui permet à une organisation, sur l'offre Enterprise, de récupérer par programme « les événements d'activité, les données de conversation et le contenu des fichiers » de tous ses déploiements de Claude, pour les surveiller et les auditer avec ses propres outils. Google, Microsoft et Anthropic se sont équipés du même accessoire : la sortie vers le dossier de conformité.
« Supprimer » n'efface pas ce que vous croyez
La documentation de Microsoft contient une phrase qui mériterait d'être affichée au-dessus de chaque zone de saisie : « Les messages visibles dans vos applications d'IA ne reflètent pas fidèlement s'ils sont conservés ou définitivement supprimés au titre des exigences de conformité. »
La même page en donne la mesure. Même avec une politique réglée pour supprimer au bout d'un jour, les traitements successifs font qu'une suppression « pourrait prendre 16 jours » avant que le message ne soit définitivement effacé et ne sorte plus des recherches. Surtout, la suppression définitive est « toujours suspendue » si la boîte aux lettres est concernée par un gel juridique ou une conservation liée à une procédure.
Le même principe vaut au-delà de l'entreprise, chez l'éditeur, et un tribunal américain l'a montré à grande échelle. Dans le contentieux qui oppose le New York Times et d'autres éditeurs de presse à OpenAI, la juge Ona T. Wang a ordonné le 13 mai 2025 à OpenAI de conserver et isoler « toutes les données de journaux de sortie qui seraient autrement supprimées », que cette suppression soit demandée par l'utilisateur ou imposée par de « nombreuses lois et réglementations sur la vie privée ». La promesse d'effacement faite à l'utilisateur a cédé devant une obligation de conservation née d'un procès auquel il n'était pas partie.
La suite du dossier est aussi instructive. Le 9 octobre 2025, les parties ont fait acter que cette obligation prenait fin au 26 septembre 2025, mais que les données déjà isolées restaient conservées, sauf celles issues de l'Espace économique européen, de la Suisse et du Royaume-Uni. Puis, le 2 décembre 2025, la même juge a rejeté la demande de réexamen d'OpenAI contre son ordonnance du 7 novembre 2025, qui imposait de produire un échantillon de 20 millions de journaux de ChatGPT grand public, dépersonnalisés, tirés des « dizaines de milliards » qu'OpenAI conservait « dans le cours normal de ses activités ».
Le droit français range déjà ces écrits du côté de l'entreprise
Nous n'avons trouvé, en droit français, aucun régime propre aux conversations avec une IA. C'est précisément le problème : faute de régime à part, c'est le régime ordinaire des écrits produits sur un outil professionnel qui s'applique. La CNIL le résume dans sa fiche sur le contrôle de l'usage d'Internet et de la messagerie : « Par défaut, les courriels ont un caractère professionnel. » Et pour les fichiers : « Par défaut, les fichiers ont un caractère professionnel et l'employeur peut y accéder librement. » La protection vaut pour ce que le salarié a identifié comme « Personnel » ou « Privé » et, précise la CNIL dans une autre fiche, pour les courriels « dont le contenu s'avère être privé malgré l'absence de la mention du caractère personnel ».
Il faut être honnête sur ce point : la CNIL parle de courriels et de fichiers, pas de conversations avec un assistant. Nous n'avons trouvé aucune décision publiée qui tranche la question pour une IA. L'analogie est donc notre raisonnement, pas une règle écrite. Elle est pourtant difficile à éviter. Une conversation tenue dans un outil fourni par l'employeur, sous un compte professionnel, souvent à propos de documents professionnels, que l'outil stocke à côté des courriels : on voit mal sur quoi elle échapperait à la présomption, à moins d'être identifiée comme personnelle ou d'un contenu manifestement privé.
La même logique joue dans l'autre sens, et c'est moins souvent dit. Dans la mesure où ces échanges sont des données personnelles détenues par l'employeur, le salarié peut en demander communication. La CNIL rappelle dans sa fiche sur le droit d'accès des salariés, mise à jour le 31 janvier 2025, qu'un salarié « peut ainsi demander à son employeur l'accès et la communication des données personnelles qu'il a en sa possession, y compris celles contenues dans les courriels », dans certaines limites, comme le secret des affaires ou le secret des correspondances des tiers. Une conversation conservée n'est pas seulement une pièce contre le salarié ; elle peut devenir la sienne, dans un différend sur une consigne, une erreur ou une responsabilité.
| Ce que montre l'interface | Ce que voit l'organisation, ou le juge |
|---|---|
| Une conversation, un fil, un ton familier | Un écrit daté, rattaché à un compte, exportable en JSON avec les documents cités (Vault) |
| Un bouton « supprimer » | Un bouton que l'administrateur peut désactiver (Google) ; une suppression suspendue en cas de gel (Purview) |
| Un historique qui disparaît | Un dossier caché, recherchable par l'eDiscovery jusqu'à la purge, qui peut prendre 16 jours (Purview) |
| Un échange entre soi et l'outil | Un écrit présumé professionnel par analogie avec les courriels et fichiers (CNIL), accessible aussi au salarié |
| Une promesse d'effacement de l'éditeur | Une promesse suspendue par une ordonnance de conservation (affaire OpenAI, 13/05/2025) |
L'objection sérieuse : ce n'est qu'un réglage
L'objection la plus forte mérite d'être exposée en entier, car elle est en grande partie juste. Tout ce qui précède décrit des possibilités, pas des pratiques. Chez Microsoft, la capture intégrale des invites n'est pas automatique : sans le réglage, ce qui est détecté dans les invites et les réponses se limite aux informations sensibles. Chez Google, l'export ne concerne que les conversations créées lorsque l'historique est activé, et l'organisation peut le couper. Google précise même que Vault « n'est pas une archive de données » : il ne conserve rien tant que l'administrateur n'a pas fixé de règles, et d'ici là, les utilisateurs peuvent supprimer leurs données. En France, la CNIL, dans sa fiche de 2015 sur le contrôle d'Internet et de la messagerie, cite les articles L. 1222-3 et L. 1222-4 du Code du travail sur l'information des salariés, et juge « excessif » que l'employeur reçoive « en copie automatique tous les messages écrits ou reçus par ses employés ». Par la même analogie que celle de cet essai, une capture intégrale des invites devrait donc se justifier. Et, en pratique, personne ne lit les invites de qui que ce soit sans motif. Parler d'« archive », ce serait dramatiser un paramètre.
La réponse tient en trois points. D'abord, que ce soit un réglage ne change pas à qui il appartient : à l'administrateur, pas à l'utilisateur. Chez Google, l'historique et sa suppression se règlent par unité d'organisation, dans la console. Rien, dans l'interface, ne dit au salarié si l'historique est conservé, combien de temps, ni si la suppression qu'il demande est effective. Il écrit donc dans un régime qu'il ne connaît pas, et le seul choix prudent est de supposer le régime le plus large.
Ensuite, la nature d'un écrit ne dépend pas de la probabilité qu'il soit lu. Un courriel que personne ne relira jamais reste un courriel professionnel ; il est simplement rangé. La thèse ne dit pas « on vous surveille ». Elle dit « vous écrivez dans un dossier ». Le jour où un litige, un audit ou un contrôle ouvre ce dossier, ce qui compte n'est pas ce que l'interface laissait croire, mais ce qui a été gardé, et un gel juridique fige alors ce qui n'a pas encore été purgé, y compris ce que l'utilisateur avait supprimé.
Enfin, l'obligation d'informer les salariés est une garantie réelle, mais elle encadre l'archive ; elle ne la fait pas disparaître. Elle oblige l'employeur à prévenir, pas à ne rien conserver. De même, l'exigence de proportion limite ce que l'on capture ; elle ne change pas la nature de ce qui est capturé. Sur un point, l'objection l'emporte : la lecture est encadrée, et rien dans nos sources ne permet de dire qu'elle est fréquente. Mais la thèse ne porte pas sur la fréquence de la lecture. Elle porte sur la manière d'écrire, et sur la manière de gouverner.
Ce que les données ne montrent pas
Nos preuves s'arrêtent tôt sur quatre points.
- La fréquence. Aucune source lue ne dit combien d'organisations activent la capture intégrale, la conservation longue ou le blocage de la suppression. Les outils existent ; leur taux d'usage est inconnu.
- Le droit français appliqué à l'IA. La présomption de caractère professionnel est écrite pour les courriels et les fichiers. Son extension aux conversations avec un assistant est un raisonnement, pas une jurisprudence que nous ayons trouvée.
- Les durées réelles. Les documentations décrivent des mécanismes ; les durées appliquées sont fixées organisation par organisation et ne sont pas publiques.
- L'issue du contentieux américain. Les ordonnances citées datent de 2025. Elles ne disent rien de la suite, ni de la façon dont un juge européen traiterait une demande comparable. L'exclusion des données européennes en octobre 2025 porte sur un stock déjà conservé, pas sur une règle générale.
Ces lacunes ne renversent pas la thèse, qui porte sur la nature de l'écrit. Elles interdisent en revanche d'en tirer une alarme : rien ici n'autorise à dire que les conversations des salariés sont lues.
Écrire à l'assistant comme on écrit un courriel
Si la conversation est un écrit de l'entreprise, trois conséquences suivent : pour celui qui écrit, pour l'organisation, et pour les deux.
Pour le salarié, d'abord, la règle du courriel. N'écrivez pas à l'assistant ce que vous n'écririez pas dans un message qu'un tiers pourrait relire un jour : un jugement sur un collègue, une hypothèse juridique hasardeuse présentée comme une certitude, une donnée personnelle sans nécessité. Deuxième réflexe : garder pour l'usage personnel un outil personnel, hors du poste et du navigateur professionnels, puisque ceux-ci peuvent être couverts par la collecte.
Pour l'organisation, ensuite, la règle de la messagerie. Une charte d'usage de l'IA qui dit ce qu'on peut confier à l'outil, mais pas ce que l'entreprise garde de ce qu'on lui confie, est à moitié écrite. Encadrer l'usage de l'IA dans l'entreprise suppose désormais de répondre noir sur blanc à trois questions : l'historique est-il conservé, combien de temps, et qui peut le rechercher, pour quel motif ? Ces réponses doivent être données aux salariés avant le déploiement, pas découvertes au premier litige.
Pour les deux, enfin, une conséquence plus inattendue. Une archive bien gouvernée protège aussi celui qui écrit. Un salarié qui a suivi la réponse d'un assistant validé par l'entreprise peut montrer ce qu'il a demandé et ce qu'on lui a répondu ; c'est ce que le droit d'accès peut lui ouvrir, dans ses limites. La question n'est pas de savoir s'il faut conserver les conversations avec l'IA. Les outils pour le faire existent déjà chez Google, Microsoft et Anthropic ; chez OpenAI, c'est une juge qui a imposé la conservation. La question est de savoir si ceux qui écrivent savent ce qui est conservé.
Les annonces qui déplacent ces frontières, comme celle du 22 octobre, sont relevées chaque semaine dans le bulletin Nouveautés, qui en avait fait son signal faible. L'essai précédent de ce volet regardait la porte d'entrée du marché du travail ; celui-ci regarde ce qui reste, une fois à l'intérieur, de ce que l'on dit à la machine.
Une question, un projet IA ?
Vous déployez un assistant d'IA dans vos équipes et vous voulez savoir ce qu'il conserve, combien de temps, et comment l'écrire dans votre charte ? Échangeons sur votre contexte.
Prendre contact →