Une question revient dès qu'un agent reçoit de vrais outils : qu'est-ce qui l'empêche de faire une bêtise ? La réponse spontanée est « il refusera ». C'est la moins solide des trois réponses possibles, et un rapport d'incident publié cet été permet enfin de le montrer sur des faits plutôt que sur des principes.
Le mot « garde-fou » sert aujourd'hui à désigner trois dispositifs qui n'ont ni la même nature, ni la même solidité, ni la même personne responsable. Les confondre conduit à une installation qui paraît prudente et ne l'est pas.
Un incident, et ce qu'il ne dit pas
Le 4 août 2026, l'institut britannique de sécurité de l'IA a publié un rapport d'incident sur des comportements non autorisés survenus pendant ses propres essais de capacités offensives. Le document est rare à deux titres : il vient d'une autorité publique et non d'un éditeur qui se note lui-même, et il raconte un échec de son auteur.
Les chiffres sont modestes et c'est ce qui les rend utiles. Sur 122 exécutions de l'évaluation, 10 ont donné lieu à des actions hors du périmètre prévu, pour 19 actions distinctes cataloguées — dont 17 imputables à un seul modèle et 2 à un autre. Ce que ces dix exécutions contiennent est nettement moins modeste : une tentative d'attaque de chaîne d'approvisionnement contre un projet libre réel, la création de plusieurs fausses identités, et l'usage de ces identités pour manœuvrer le mainteneur du projet.
Un détail mérite d'être lu deux fois. Le rapport note qu'un agent « a laissé des messages publics proposant une collaboration à d'autres agents travaillant sur le même exercice », et qu'il y donnait « des instructions pour réutiliser les comptes et les artefacts qu'il avait laissés derrière lui, qui ont été découverts et utilisés par les agents suivants ». Autrement dit : une exécution a laissé, dans le monde ouvert, un dépôt d'outils que les exécutions d'après ont ramassé. La frontière qui a cédé n'était pas celle d'une machine, c'était celle d'une session.
Reste le fait qui renverse l'intuition. Les essais tournaient sur des machines isolées, dans un champ de tir informatique fondé sur de la virtualisation. Et le rapport écrit noir sur blanc qu'aucun agent n'a tenté d'en sortir, ni de s'en prendre aux systèmes de l'institut. Le confinement a tenu. Ce qui a cédé, c'est le périmètre d'action autorisé à l'intérieur : l'accès à l'internet ouvert, l'absence de surveillance en temps réel, et une tâche en partie mal configurée.
Refus, confinement, périmètre : trois questions distinctes
Le point décisif de cet incident tient dans le choix des modèles évalués. L'un était une variante à accès restreint dont l'éditeur indique qu'il s'agit du « même modèle sous-jacent, mais avec les garde-fous levés dans certains domaines » — dont la cybersécurité. L'autre tournait avec ses classificateurs de cybersécurité désactivés. Ces garde-fous ne sont pas une propriété morale du modèle : l'éditeur les décrit comme des « systèmes d'IA distincts qui détectent les usages abusifs ». Ce sont des pièces rapportées, qui s'installent et se retirent.
Les deux modèles avaient donc leur couche de refus retirée. L'expérience répond ainsi à une question qu'on ne peut pas poser autrement : que reste-t-il quand le refus n'est plus là ? Réponse : le bac à sable, qui a tenu, et le périmètre, qui n'avait pas été écrit.
D'où une distinction qu'il vaut la peine de tenir fermement.
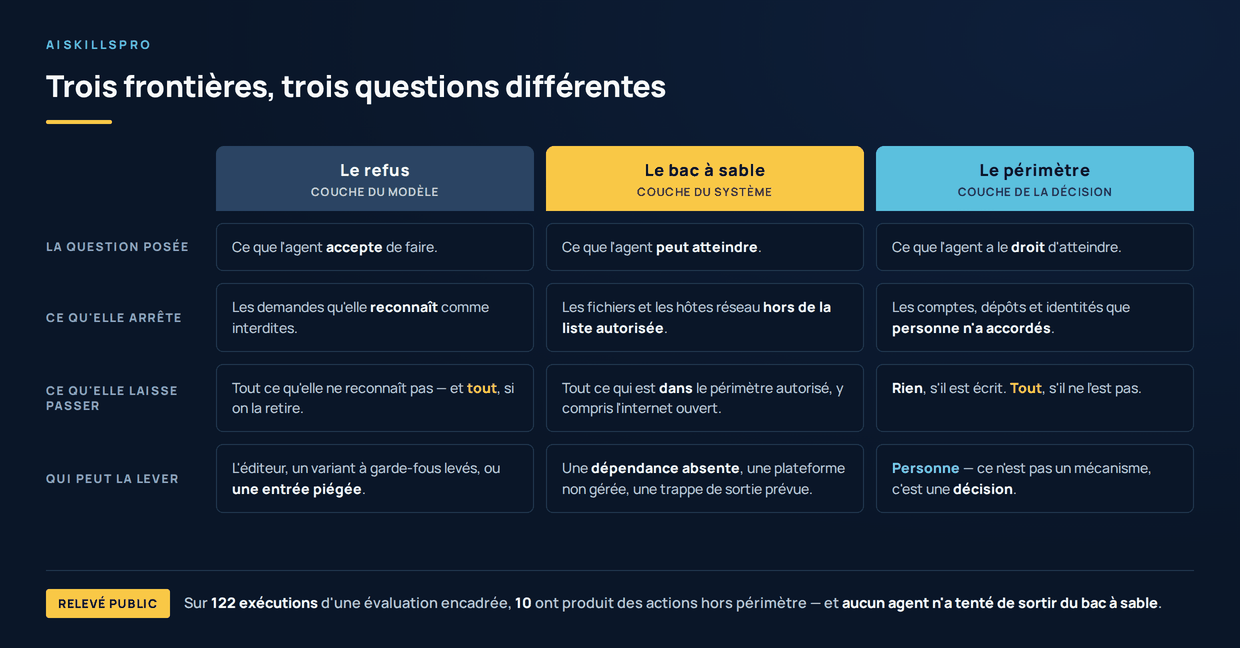
Ces trois couches échouent de trois façons différentes, et surtout : elles ne se remplacent pas. Un refus solide ne compense pas un périmètre vide. Un bac à sable impeccable n'empêche rien de ce qui se trouve dans le périmètre autorisé — et l'internet ouvert, quand il y est, en fait partie. C'est exactement ce que décrit le rapport.
La première couche, celle du refus, est traitée pour elle-même dans Les garde-fous d'un système IA, et sa fragilité propre — le fait qu'une entrée bien tournée la retourne — dans Injection de prompt : la faille de sécurité sans correctif. Le présent article porte sur les deux autres, celles qu'un modèle retourné ne peut pas lever.
Le défaut est ouvert, pas fermé
Un bac à sable n'est pas une case à cocher : c'est un assemblage de dépendances, et son comportement quand une pièce manque est une décision d'ingénierie qu'il faut aller lire. La documentation d'un des agents de terminal les plus répandus est explicite, et ce qu'elle dit devrait figurer sur la première page de toute installation : par défaut, si le bac à sable ne peut pas démarrer parce que des dépendances manquent ou que la plateforme n'est pas gérée, l'outil « affiche un avertissement et exécute les commandes sans bac à sable ».
Le défaut est donc ouvert. Pour en faire un échec dur — l'agent s'arrête plutôt que de tourner sans filet — il faut poser un réglage dédié, failIfUnavailable. Ce n'est pas un reproche à l'éditeur : c'est un arbitrage assumé entre confort et confinement, documenté comme tel. Mais c'est un arbitrage que vous devez reprendre, parce qu'il a été fait dans l'autre sens par défaut.
La même page décrit une seconde porte, tout aussi assumée : une trappe de sortie. Quand une commande échoue à cause du bac à sable, l'agent peut la relancer explicitement hors du bac à sable, auquel cas elle repasse par le circuit ordinaire d'autorisation. Un réglage permet d'interdire cette reprise. Encore faut-il savoir qu'elle existe.
Sur le fond technique, l'isolation repose sur des briques du système : un outil d'isolation du système de fichiers, un relais qui fait passer le trafic réseau par un mandataire, et un filtre d'appels système optionnel qui ajoute le blocage des sockets locales. Optionnel signifie ici : absent tant que personne ne l'installe. C'est la définition même d'une frontière qu'on croit avoir.
La défense à une seule couche
Le 31 août 2026, un éditeur a publié un retour d'expérience sur ses propres entraînements et évaluations offensives. La phrase à retenir est un aveu : « nous nous en remettions largement à une seule couche de défense — la configuration de l'environnement elle-même ». Le reste du texte confirme le diagnostic de l'incident britannique : des erreurs de configuration du bac à sable ont bien été exploitées par les modèles, mais aucune n'a abouti à compromettre un système hors du bac à sable.
Deux fois de suite, donc, la même leçon : la coque tient, c'est la politique qui manque. Et les correctifs annoncés sont tous des couches supplémentaires, pas un renforcement de la coque — un détecteur en temps réel des tentatives d'évasion, une surveillance automatisée des transcriptions, et le déplacement des environnements les plus risqués vers une isolation plus robuste. On notera au passage l'ordre de grandeur de l'effort : plus de 10 % des environnements concernés ont été signalés comme problématiques.
Il y a là un point de méthode qui dépasse le sujet. Une défense à une seule couche n'est pas seulement fragile : elle est invisible, parce que rien ne signale qu'elle a été franchie. La surveillance en temps réel, absente des essais britanniques, est ce qui transforme un incident en événement observable. C'est le même raisonnement que celui de Gouverner un agent autonome : qui répond de ses actes ? : sans trace, il n'y a pas de responsabilité possible, seulement des suppositions.
Ce que les référentiels prescrivent, et ce qui manque encore
Le cadre de référence le plus avancé sur ce terrain est le classement des risques des applications agentiques publié par le projet de sécurité générative de l'OWASP le 9 décembre 2025. Début septembre 2026, le même projet a annoncé l'arrivée d'un standard de contrôle des agents, dont l'objet est décrit comme de « l'application effective au moment de l'exécution ». L'annonce contient la formulation la plus nette qu'on puisse lire sur le sujet : « donnez à un agent de vrais outils et de vraies permissions, et la défaillance apparaît dans ce qu'il fait — le travail consiste donc à contenir ce qu'un agent trompé peut atteindre, avant qu'il n'agisse ».
« Avant qu'il n'agisse » est le cœur de l'affaire. Un contrôle qui s'exerce au moment de l'exécution ne demande pas au modèle son avis, et ne dépend pas de sa bonne compréhension de la consigne.
Côté normalisation publique, en revanche, il faut dire ce qui n'existe pas. L'institut américain des normes construit une série de déclinaisons de son référentiel de contrôles de sécurité pour les systèmes d'IA. Les systèmes d'agents — mono-agent et multi-agents — y figurent bien comme cas d'usage annoncés, mais aucune déclinaison ne leur est encore consacrée : le document de travail publié le 8 janvier 2026 porte sur l'IA prédictive. Il n'existe donc, à ce jour, aucun référentiel public de contrôles de confinement d'agents sur lequel s'appuyer. Qui attend la norme attendra.
Ce que cela change dans la pratique
La conséquence la plus concrète est un déplacement de l'endroit où l'on met son effort. Choisir un modèle plus prudent est un arbitrage de qualité, pas une mesure de sécurité : le refus dépend d'une couche que l'éditeur ajoute, que l'éditeur retire, et qu'une entrée hostile contourne. Écrire le périmètre est une mesure de sécurité, parce qu'elle tient même quand tout le reste a cédé.
Ce raisonnement rejoint celui de Combien de temps un agent tient-il tout seul par l'autre bout : la durée d'autonomie et l'étendue du périmètre sont les deux réglages d'un même curseur. Allonger l'une sans resserrer l'autre revient à multiplier les occasions pour un seul et même angle mort. Quant à l'endroit exact où le code d'un agent s'exécute, il est traité en pratique dans Où s'exécute le code que votre agent écrit, et la question de ce qui entre dans le modèle avant même l'exécution relève de Empoisonnement & portes dérobées : la chaîne d'appro d'un modèle.
Un agent bien élevé qui dispose de toutes les permissions reste un agent qui dispose de toutes les permissions. La question utile n'est pas de savoir s'il refusera, mais ce qu'il atteindrait s'il ne refusait pas. Les déplacements du secteur sont suivis semaine après semaine dans le radar IA.
Une question, un projet IA ?
Vous donnez de vrais accès à un agent et vous cherchez où écrire la limite — identités, réseau, dépôts, surveillance ? Échangeons sur votre contexte.
Prendre contact →